
O singură dependență compromisă poate expune mii de victime. Care este promisiunea AI? Mulți ar spune că eficiența: eliminarea lacunelor generate de activitatea umană și automatizarea sarcinilor repetitive – promisiune care lasă însă multe aspecte neclarificate, mai ales din perspectiva securității.
De exemplu, atunci când dezvoltatorii folosesc metoda „vibe coding”, iar utilizatorii descarcă modele, agenți și skill-uri asociate acestora din depozite (repositories) publice, devine tot mai dificil de stabilit dacă fiecare componentă a procesului este de încredere. Vorbim despre un lanț de aprovizionare digital: modelele AI, instrumentele copilot dezvoltate de terți, framework-urile pentru agenți și fluxurile de lucru bazate pe AI creează noi dependențe.
Iar incidentele recente care au vizat lanțul de aprovizionare npm (Node Package Manager) arată că încrederea poate amplifica riscurile la fel de rapid cum poate crește productivitatea. În domeniul AI, urmărirea unor câștiguri rapide, fără o verificare atentă, ar putea fi exact locul în care apare următoarea verigă slabă.
Idei principale:
– Adoptarea AI extinde lanțul de aprovizionare al companiilor dincolo de pachetele software, adăugând modele, agenți, skill-uri, plug-in-uri și surse externe de date în ecuația încrederii.
– Atacurile care exploatează dependențele software tradiționale, precum cele asupra npm, reprezintă un avertisment relevant pentru domeniul AI: componentele de încredere pot deveni vectori de atac atunci când verificările de securitate sunt insuficiente.
– AI-ul agentic schimbă perspectiva asupra riscurilor, deoarece aceste instrumente pot naviga pe internet, accesa și prelua date, apela servicii și acționa în numele utilizatorilor, nu doar genera text.
– Soluția nu este evitarea completă a AI, ci gestionarea accesului agenților, blocarea dependențelor periculoase înainte de utilizare și monitorizarea comportamentului lor în timpul executării sarcinilor.
– Nici utilizarea AI on-premises (găzduit în infrastructura proprie) nu elimină problema. Atacurile prin prompt injection, skill-urile compromise, pachetele malițioase și monitorizarea insuficientă pot transforma automatizările de încredere în amenințări la adresa companiei.
Lanțul de aprovizionare digital
Nu este un secret că lanțul de aprovizionare digital a reprezentat, de-a lungul anilor, o sursă de numeroase probleme pentru companii, unele dintre cele mai importante incidente de securitate având la bază utilizarea unor produse sau instrumente furnizate de terți, precum SolarWinds Orion. Cu toate că incidentele care afectează lanțul de aprovizionare la scară largă pot avea consecințe majore, chiar și utilizarea individuală, fără precauțiile necesare, a instrumentelor AI poate provoca daune considerabile unei companii.
Acum, întrebarea nu este doar ce conțin aceste lanțuri și de ce sunt vizate de atacatori, ci și ce le conferă atât de multă putere. Să luăm ca exemplu bibliotecile software, precum lodash, requests sau react. Ele există deoarece nu se poate aștepta ca dezvoltatorii să scrie singuri fiecare componentă a unei aplicații. Chiar și dezvoltarea unei aplicații relativ simple poate dura săptămâni sau luni, în timp ce realizarea unui software enterprise, pregătit pentru utilizare în producție, necesită adesea și mai mult timp.
Bibliotecile software rezolvă problema, permițându-le echipelor să reutilizeze cod deja testat și validat, în loc să construiască totul de la zero. Însă aceeași facilitate vine și cu riscuri asociate dependențelor software. Un pachet utilizat pe scară largă, precum axios, unul dintre cei mai populari clienți HTTP pentru JavaScript din npm, poate fi integrat în nenumărate aplicații. Astfel, încrederea acordată unei singure componente se poate extinde asupra unei mari părți a ecosistemului software. Exploatarea acestei încrederi devine, prin urmare, factorul care face posibil atacul.
Pentru cei care nu sunt familiarizați cu termenul: Ce este npm?
npm este principalul ecosistem de gestionare a pachetelor pentru JavaScript (un limbaj de programare). Le permite dezvoltatorilor să descarce și să reutilizeze cod open-source, fără a fi nevoiți să construiască fiecare componentă de la zero.
Anul atacurilor asupra lanțului de aprovizionare npm
Să luăm un exemplu concret. Ecosistemul npm a demonstrat în repetate rânduri cât de vulnerabilă poate deveni încrederea acordată dependențelor software. Începând din 2025, campanii precum Shai-Hulud și Mini Shai-Hulud au folosit mecanisme de propagare asemănătoare viermilor informatici, răspândindu-se prin intermediul relațiilor de încredere dintre pachetele software. Atacurile au vizat furtul credențialelor dezvoltatorilor și al celor utilizate în serviciile cloud, pentru a publica ulterior versiuni compromise ale pachetelor.
Însă furtul de credențiale nu este singura metodă de atac. În alte situații, atacatorii pot exploata fluxurile de lucru ale administratorilor de pachete (maintaineri), confuzia între dependențe, actualizările malițioase sau procesele de construire a software-ului (procesele de build) compromise.
În ambele situații, pericolul nu vine doar din codul malițios, ci și din sistemele de instalare și construire a software-ului (build), considerate de încredere, care pot facilita răspândirea sa și a activităților malițioase. Mai grav, aceleași dependențe bazate pe încredere își fac acum loc și în infrastructurile AI pe care companiile le adoptă cu prea multă ușurință.
Inamicul din interior: AI, încredere și skill-uri cu riscuri majore
În goana după creșterea productivității (deși rezultatele în acest sens sunt discutabile), companiile adoptă rapid o multitudine de modele AI, convinse de mesajele companiilor din domeniu, susținute de bugete masive de marketing, dar și de unele rezultate1 concrete. Adesea, adoptarea are loc indiferent dacă există sau nu o nevoie reală de astfel de soluții. Un lucru este însă cert: în anumite situații, utilizarea AI este binevenită și poate aduce beneficii reale. Însă toate acestea sunt aspecte secundare. Ceea ce contează cu adevărat sunt punctele vulnerabile de securitate pe care le creează adoptarea AI. Să vedem cum se manifestă ele printr-un exemplu concret.
Să presupunem că o agenție de marketing integrează un bot AI, dotat cu capabilități agentice, pentru a automatiza câteva sarcini administrative, cum ar fi realizarea rapoartelor. În același timp, echipa de marketing îl poate utiliza și în scopuri creative, valorificându-i capacitățile generative. Desigur, modelul are acces la internet, deoarece posibilitatea de a căuta online surse de inspirație este o funcționalitate utilă în contextul dat.
Totuși, o astfel de configurare creează un lanț de încredere. Agenția nu mai acordă încredere doar furnizorului soluției AI, ci și modului în care modelul navighează pe internet, surselor din care preia informații, plug-in-urilor sau conectorilor pe care îi utilizează, prompturilor pe care le primește și permisiunilor de acces de care dispune în infrastructura companiei.
Dacă botul are acces la rapoartele de campanie, la unitățile de stocare partajate, la briefurile clienților, la platformele de analiză sau la arhivele de emailuri, rolul său de „asistent administrativ” ajunge rapid să semene cu cel al unui angajat junior, care dispune de acces extins la informațiile companiei, dar are foarte puțin discernământ în identificarea situațiilor suspecte.
Să presupunem acum că, în timpul unei activități de cercetare online, botul accesează o pagină web compromisă (sau un document malițios), care pare a fi un ghid de marketing. Pentru un cititor (uman), pagina ar putea părea o simplă colecție de recomandări generale pentru îmbunătățirea performanței reclamelor. În schimb, pentru sistemul AI, instrucțiunile ascunse în conținutul paginii ar putea încerca să suprascrie sarcina inițială și să determine botul să extragă date interne despre campanii, să sintetizeze informații despre clienți sau să transmită rezultatele către un endpoint controlat de atacatori, dacă vreunul dintre instrumentele conectate îi permite. Este forma de exploatare a dependențelor specifice AI. Componenta malițioasă nu mai este un pachet software descărcat, ci o sursă externă nesigură, pe care sistemul o integrează în fluxul său de lucru și o tratează ca pe o sursă de încredere.
Iar pentru că botul acționează în numele unor utilizatori reali, efectele pot fi greu de observat. Nimeni nu a dat click pe un link suspect și nu a descărcat malware, așa cum se întâmplă în atacurile tradiționale. Niciun dezvoltator nu a instalat intenționat o bibliotecă software compromisă. Compania pur și simplu a conectat un instrument util la date relevante, i-a oferit acces la internet și a presupus că rezultatele generate se vor limita la sarcina atribuită.
Însă, odată ce sistemele AI pot prelua și interpreta informații, dar și acționa în mod autonom, fiecare sursă externă pe care o accesează devine parte a lanțului operațional de aprovizionare. Avem deja incidente recente în care agenții AI au reușit să depășească limitele impuse mediului de testare.
„Atunci când platformele bazate pe AI sunt dezvoltate în ritm accelerat, măsurile esențiale de securitate cibernetică și protecție a datelor sunt adesea primele neglijate”, a declarat Jake Moore, specialist ESET în conștientizarea riscurilor de securitate cibernetică. „Riscul real nu este reprezentat de agenții AI în sine, ci de infrastructura din spatele lor, unde bazele de date expuse și mecanismele de autentificare implementate superficial pot transforma o simplă scăpare într-o breșă de securitate gravă.”
Skill-uri AI cu riscuri majore
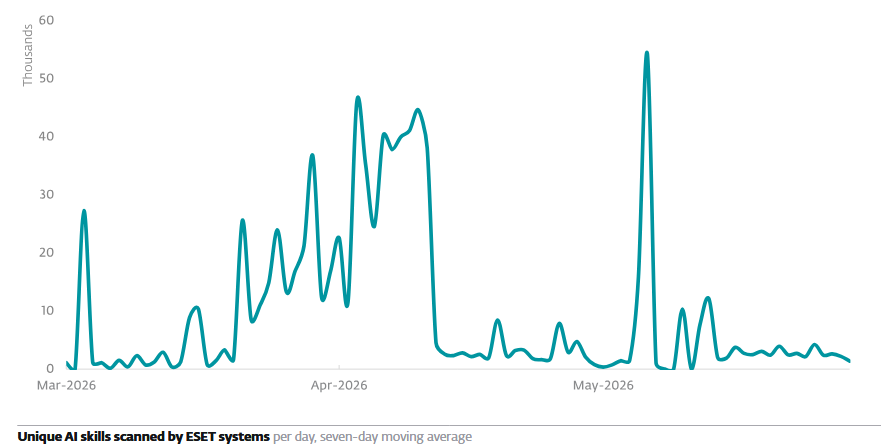
Un exemplu de vulnerabilități îl reprezintă miile de skill-uri AI malițioase identificate de ESET Research. ESET a analizat peste 900.000 de skill-uri AI disponibile în depozite populare și a constatat că 25.000 dintre ele prezentau elemente suspecte, iar peste 3.000 erau în mod clar malițioase.
Pentru cei care nu sunt familiarizați cu termenul, aceste skill-uri sunt, în esență, mici ghiduri de lucru destinate agenților AI. Ele îi indică agentului ce sarcini trebuie să îndeplinească, ce instrumente sau servicii să utilizeze și la ce date ar putea avea nevoie de acces pe parcurs. Într-un context legitim, utilitatea lor este evidentă: permit creșterea capacităților AI-ului agentic, asigură o execuție mai consecventă a sarcinilor și facilitează integrarea sa în fluxurile de lucru ale companiilor.
Vă îngrijorează siguranța unui skill AI pe care l-ați descărcat? Verificați-l cu ajutorul instrumentului ESET Skills Checker.
Problema este că aceste skill-uri pot deveni, la rândul lor, un mijloc eficient de ascundere a intențiilor malițioase. Un skill poate fi compromis sau conceput încă de la început pentru a determina, în mod discret, agentul să se abată de la instrucțiunile utilizatorului. Consecințele pot include extragerea și transmiterea neautorizată a datelor, descărcarea și executarea de malware, suprascrierea instrucțiunilor utilizatorului, modificarea treptată și subtilă a comportamentului agentului sau chiar modificarea skill-ului în sine, pentru a face compromiterea mai dificil de detectat.
Credit Claw
Un exemplu relevant de astfel de skill identificat în urma scanărilor efectuate de ESET este Credit Claw. Îi permite agentului AI să efectueze achiziții prin platforme precum Amazon și Shopify și să se conecteze la medii software de tip SaaS (Software-as-a-Service). Riscul constă în accesul pe care îl oferă la metodele de plată și, implicit, direct la banii utilizatorului. O actualizare malițioasă sau o dependență compromisă ar putea modifica pe ascuns comportamentul agentului, redirecționând produsele sau serviciile achiziționate către atacator.
Este una dintre principalele provocări ale AI-ului agentic. În cazul chatboturilor, decizia finală îi aparține utilizatorului, chiar dacă poate fi influențată prin tehnici de manipulare a datelor (data poisoning). În schimb, agenții AI pot acționa autonom, ceea ce face supravegherea lor mult mai dificilă, mai ales atunci când un agent își poate modifica treptat comportamentul, trecând de la unul legitim la unul malițios.
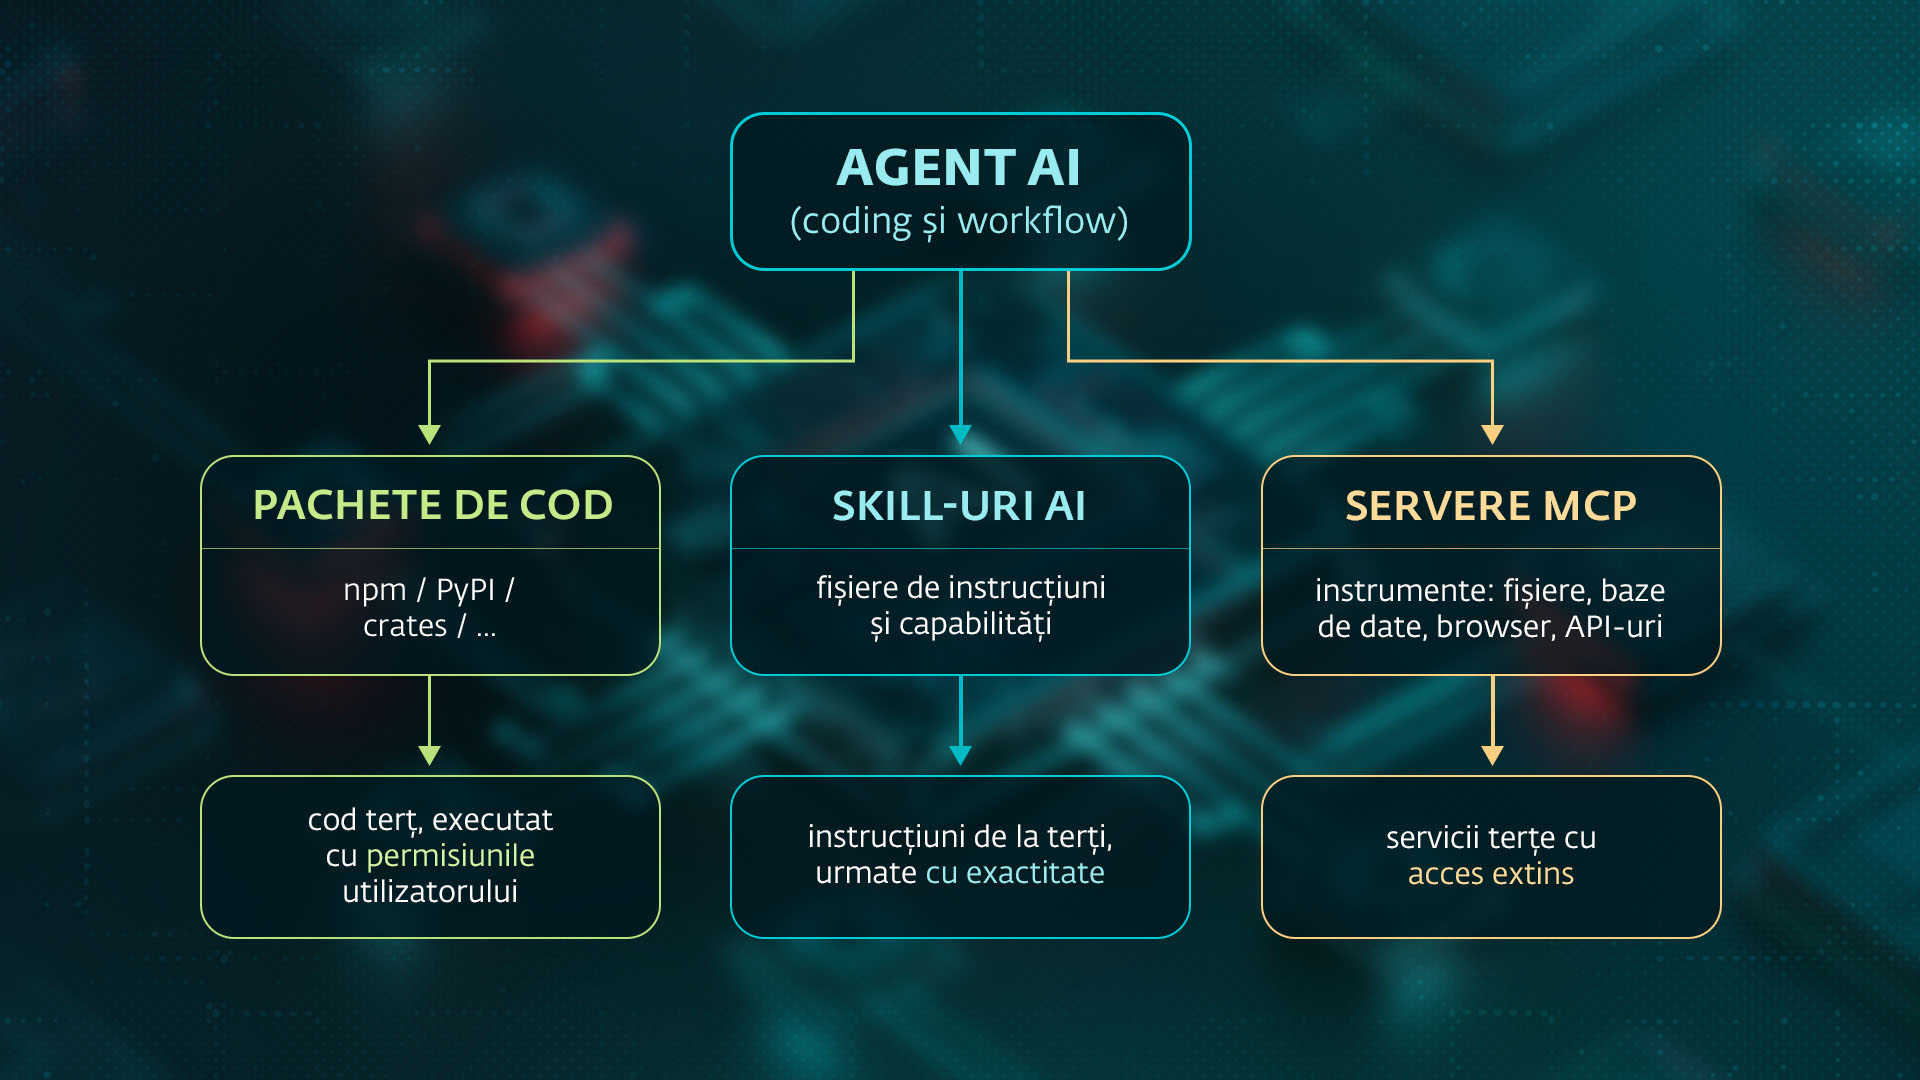
Lanțul de aprovizionare al agenților AI reprezintă, în sine, o suprafață de atac extrem de complexă.
Din nou, percepție versus realitate
Potrivit ESET SMB Cyber Readiness Index 2026, peisajul securității cibernetice nu s-a schimbat fundamental. Ceea ce s-a schimbat este perspectiva asupra riscurilor, amplificată de percepțiile exagerate legate de AI. Alte cercetări2 ESET confirmă tendința, cu o precizare importantă: percepțiile sunt influențate de o înțelegere deficitară a securității cibernetice în rândul angajaților companiilor participante la sondaj. Așadar, dacă organizațiile știu că AI implică riscuri suplimentare, de ce continuă să adopte aceste tehnologii? Potrivit Indexului, 70% dintre companii recunosc că AI introduce riscuri suplimentare, însă doar 60% au implementat o politică de securitate și guvernanță pentru AI.
În practică, IMM-urile ar putea supraestima amenințarea reprezentată de malware-ul bazat pe AI, subestimând în același timp riscurile asociate adoptării unor sisteme AI care au deja acces legitim la infrastructura companiei. Pe măsură ce agenții AI devin capabili să acționeze în numele utilizatorilor, provocarea nu mai constă doar în blocarea codului malițios, ci și în monitorizarea automatizărilor considerate de încredere. Un endpoint compromis poate fi izolat. În schimb, un skill AI malițios care operează în cadrul unor fluxuri de lucru aprobate este mult mai dificil de identificat.
Și nici măcar nu am adus în discuție fenomenul de shadow AI, o amenințare mult mai puternică și mai greu de identificat.
Obișnuința reduce vigilența
Dacă atacurile asupra npm i-au învățat pe dezvoltatori să verifice atent ce componente integrează în aplicațiile lor, AI-ul agentic ar trebui să determine companiile să se întrebe ce anume integrează în procesele lor decizionale. Instalarea unui skill AI ar putea deveni, în curând, un gest la fel de obișnuit precum instalarea unei extensii de browser, a unui plug-in SaaS sau a unui pachet open-source. Iar tocmai aceasta este problema.
Ecosistemul skill-urilor AI preia, de exemplu, multe dintre riscurile asociate lanțului de aprovizionare, întâlnite și în cazul software-ului open-source, al extensiilor de browser, al pachetelor npm și al instrumentelor utilizate de dezvoltatori. Cum se explică acest fapt? Agenții AI se bazează pe diverse componente externe, precum pachetele software (npm, PyPI, crates), skill-urile AI (prezentate mai sus) și serverele Model Context Protocol (MCP) – servicii care le pun la dispoziție instrumente precum accesul la fișiere, interogarea bazelor de date sau controlul browserului.
Da, și pachetele npm joacă un rol important în ecosistem. Să analizăm acum implicațiile.
Fiecare dintre componente se bazează, la rândul său, pe cod sau instrucțiuni create de persoane necunoscute de pe internet. Toate au fost deja exploatate de atacatori prin intermediul unor metode precum:
– Pachete software cu denumiri înșelătoare (typosquatting) – care imită biblioteci populare, dar conțin cod malițios.
– Servere MCP malițioase care, odată conectate, pot accesa toate informațiile la care are acces agentul și pot executa comenzi prin intermediul instrumentelor disponibile.
– Fișiere de skill și seturi de date compromise – care conțin instrucțiuni ascunse, pe care agentul AI le execută fără să le pună la îndoială.
Un aspect esențial este că agenții AI instalează automat aceste dependențe, cu viteza unui sistem automatizat, fără ca o persoană să aibă timp să le verifice. Astfel, ne confruntăm cu problema clasică a lanțului de aprovizionare software, însă fără acel punct de control uman. În aceste condiții, ce perspective mai are monitorizarea securității? Practic, operează în orb.
Revenim în zona gri
Anterior, am făcut referire la zona „oarbă” sau gri a securității cibernetice, în contextul aplicațiilor legitime de monitorizare și administrare la distanță, care pot fi utilizate în scopuri malițioase, deși au fost instalate inițial în mod legitim. Merită să revenim asupra acestui aspect, deoarece și componentele compromise ale lanțului de aprovizionare software pot intra în zona gri. Instrumente legitime și de încredere pot deveni puncte de acces compromise, așa cum s-a întâmplat în cazul SolarWinds Orion.
Nu este realist să anticipăm care va fi următoarea componentă exploatată, întrucât aceste atacuri vizează tocmai încrederea implicită de care astfel de instrumente beneficiază deja în cadrul sistemelor informatice ale companiilor. Totuși, înainte de a respinge complet aceste tehnologii, trebuie să reținem că încrederea poate fi gestionată, iar atacurile pot fi în continuare detectate.
Eliminarea AI din zona gri
În ce privește skill-urile AI, organizațiile au mai multe posibilități de intervenție decât ar putea părea la prima vedere. Problema nu este dorința companiilor de a experimenta instrumente noi – un lucru firesc, mai ales în contextul promisiunilor privind creșterea productivității și al presiunii concurențiale. Problema apare atunci când aceste experimente sunt tratate ca fiind lipsite de riscuri.
În multe privințe, comoditatea reduce vigilența. Atunci când un skill AI, un conector sau un agent promite beneficii imediate, tentația poate fi de a-l integra mai întâi și de a pune întrebările legate de securitate abia ulterior. Însă, în lanțul de aprovizionare AI, fiecare funcționalitate nouă adăugată presupune și o nouă dependență. Prin urmare, prevenția trebuie să înceapă înainte ca aceste dependențe să fie integrate în fluxurile de lucru.
Așadar, cum putem scoate AI din această așa-numită zonă gri? Soluția este relativ simplă. Trebuie să ne uităm la locul în care are loc utilizarea AI: endpoint-ul. Acesta este, până la urmă, punctul central al activității, unde angajații caută, încarcă și primesc date. V-ați putea întreba: „Dar majoritatea agenților AI nu funcționează în cloud?”. Ba da. Cu toate acestea, datele sunt în continuare trimise și primite prin intermediul endpoint-urilor, adică al dispozitivelor de pe care utilizatorii interacționează cu sistemele AI.
„AI reprezintă o nouă categorie de entitate activă în cadrul companiei. Citește, scrie, ia decizii și execută acțiuni – în mod ideal, cu acordul unei persoane. Trebuie să beneficieze de aceeași atenție din perspectiva securității ca utilizatorii și endpoint-urile, deoarece îndeplinește simultan rolurile ambelor categorii”, a declarat Kamil Pšenák, senior product manager la ESET.
Cum securizăm stiva AI
Problema este că termenul „stiva AI” are o anumită încărcătură și poate fi interpretat în mai multe feluri. Pentru a înțelege mai bine ce presupune, să împărțim utilizarea AI în cadrul unei companii pe mai multe niveluri distincte.
– Utilizatorii: Persoanele care interacționează cu modelele lingvistice de mari dimensiuni (LLM) prin intermediul aplicațiilor și browserelor.
– Aplicațiile cu funcții AI: De exemplu, o aplicație de procesare a textelor care dispune de funcții native bazate pe AI pentru editarea conținutului.
– Agenții AI: Cu alte cuvinte, aplicații software autonome care acționează în funcție de anumite obiective, cum ar fi programarea, automatizarea fluxurilor de lucru sau îndeplinirea unor sarcini interne ale companiei.
– Lanțul de aprovizionare al agenților AI: Așa cum am menționat anterior, include pachetele software, skill-urile AI, serverele MCP și plug-in-urile utilizate.
– Mediul de execuție și infrastructura: Locul în care se desfășoară efectiv activitatea: endpoint-uri, echipamente dedicate, mașini virtuale, cloud privat, platforme pentru dezvoltarea agenților AI (precum Prismatic sau n8n) etc.
– Modelele (LLM-uri): Pot fi accesate prin intermediul interfețelor de programare a aplicațiilor (API) din cloud-ul public sau pot fi găzduite de furnizori ori implementate on-premises (în infrastructura proprie).
„Privite în ansamblu, aspectul esențial este că fiecare dintre niveluri comunică cu celelalte. Fiecare dintre ele reprezintă un canal prin care datele pot fi divulgate sau prin care pot fi preluate instrucțiuni malițioase. Cu alte cuvinte, orice element care extinde contextul AI poate deveni un vector de atac”, a declarat Filip Mazán, directorul AI Security Labs din cadrul ESET. Având în vedere că majoritatea resurselor AI provin din surse externe, găzduite de terți, este evident că o mare parte din zona gri se concentrează aici.
Însă ar fi o simplificare prea mare să afirmăm că este vorba strict despre o problemă de securitate a serviciilor cloud. Este tentant să credem că, dacă modelele lingvistice de mari dimensiuni (LLM) și agenții AI rulează pe serverele proprii ale companiei, am avea mai multă transparență și un nivel mai ridicat de securitate în ce privește agenții și modelele utilizate. Totuși, găzduirea on-premises rezolvă o singură problemă de securitate: prompturile nu mai sunt trimise către un furnizor terț. Ceea ce reprezintă un avantaj important, mai ales pentru organizațiile preocupate de confidențialitatea datelor.
Totuși, această soluție nu elimină următoarele riscuri:
– Un model găzduit on-premises este la fel de vulnerabil la atacurile de tip prompt injection. Vulnerabilitatea ține de modul în care modelele lingvistice de mari dimensiuni (LLM) procesează textul, nu de locul în care sunt găzduite.
– Un agent AI care utilizează un model on-premises poate executa în continuare comenzi malițioase, poate instala pachete compromise și poate fi manipulat prin conținutul pe care îl citește.
– Modelul în sine face parte din lanțul de aprovizionare: modelele cu ponderi deschise (open-weight) sunt descărcate din depozite publice și pot fi modificate sau pot conține mecanisme ascunse de tip backdoor. „Nu poți ști cu adevărat ce face sau nu face parte din datele de antrenare”, a declarat Mazán.
– Riscul scurgerilor de date interne rămâne. Un sistem AI intern, care are acces la documente de resurse umane, le poate divulga unui angajat care nu ar trebui să aibă acces la ele.
– În continuare, nu ai nicio vizibilitate asupra persoanelor care utilizează AI sau agenți AI și asupra scopului în care îi folosesc, decât dacă dezvolți propriile mecanisme de monitorizare.
„În cazul AI-ului agentic, o breșă de securitate nu mai trebuie neapărat să se manifeste sub forma unui malware. Uneori, poate lua forma unui asistent de încredere care execută întocmai ceea ce i s-a cerut… dar la indicația unei surse greșite. Fie că vorbim despre un LLM public, unul găzduit de un furnizor sau unul implementat on-premises, faptul că locația schimbă anumite riscuri nu este esențial, deoarece majoritatea lor sunt generate de comportamentul sistemului. De aceea, securitatea AI trebuie să acopere întreaga stivă AI, nu doar modelul”, a declarat Pšenák.
Știați că? Modelele cu ponderi deschise (open-weight)
Modelele AI open-weight sunt modele ale căror parametri rezultați în urma antrenării (ponderile) sunt disponibili pentru descărcare, analiză și rulare de către alte persoane, prin intermediul unor platforme precum Hugging Face. Asemenea software-ului open-source, modelele open-weight oferă utilizatorilor mai mult control și transparență, însă nu sunt întotdeauna complet open-source: datele de antrenare, codul sau condițiile de utilizare pot fi în continuare restricționate.
ESET analizează riscurile lanțului de aprovizionare AI
În realitate, provocarea securizării AI nu diferă fundamental de cea a securizării lanțurilor de aprovizionare tradiționale, însă se manifestă la o scară mult mai mare. Numărul și diversitatea componentelor care contribuie în prezent la „optimizarea” proceselor de business au crescut, ceea ce impune și extinderea măsurilor necesare pentru reducerea riscurilor. ESET poate ajuta organizațiile să reducă riscurile asociate AI-ului agentic pe două planuri: în primul rând, prin protejarea componentelor pe care agenții autonomi le integrează în propriile procese și, în al doilea rând, prin monitorizarea activității lor. Iată cum:
ESET AI Agent Security
În primul rând, abordarea ESET pentru prevenirea activităților malițioase ale agenților AI este una proactivă. Ecosistemul public din care își preiau resursele – diverse pachete software, skill-uri AI și servere – este monitorizat continuu, iar artefactele malițioase sunt detectate fără a fi necesară rularea sau analizarea lor cu ajutorul unui sistem AI. Aceste măsuri de protecție sunt aplicate la două niveluri ale endpoint-ului:
– La nivel de URL: Un pachet software, un skill AI sau un server MCP malițios este blocat în momentul descărcării, înainte de a ajunge pe dispozitiv.
– La nivel de fișier: Dacă artefactul se află deja pe dispozitiv, acesta este detectat și blocat direct pe disc, înainte ca vreun agent AI să poată accesa conținutul său.
Elementul esențial este că blocarea are loc înainte ca agentul AI să poată accesa artefactul. Astfel, dependența compromisă nu ajunge niciodată să facă parte din mediul de lucru al agentului. În acest fel, timpul de răspuns se reduce de la zile întregi de scanare la o singură interogare. Totuși, măsura nu este suficientă, de una singură, pentru a securiza întregul lanț de aprovizionare al agenților AI.
ESET AI Behavioral Monitoring
Al doilea element esențial pentru securizarea completă a lanțului de aprovizionare al agenților AI este protecția împotriva comportamentelor potențial malițioase. Agenții autonomi, precum asistenții de programare integrați în VS Code, Claude Code, OpenClaw și alte soluții similare, execută comenzi reale pe dispozitive reale. ESET Behavioral Monitoring le monitorizează și controlează activitatea direct la nivelul endpoint-ului, prin intermediul următoarelor mecanisme:
– Interzicerea utilizării: O companie poate decide că acești agenți nu sunt permiși în infrastructura sa. În acest, agenții sunt identificați și blocați complet.
– Utilizarea monitorizată: Atunci când utilizarea agenților este permisă, fiecare acțiune a lor este monitorizată. Când un agent încearcă să execute o comandă shell, conținutul său este verificat pentru a identifica eventualele intenții malițioase, înainte de executare. Astfel, un agent compromis prin injectarea unor instrucțiuni care încearcă să transmită un script de la distanță către un shell, să extragă fișiere, să compromită datele de autentificare sau să modifice configurația sistemului este blocat chiar în momentul în care încearcă să execute aceste acțiuni, indiferent de modul în care a fost manipulat.
Aceasta este securitate comportamentală în sensul clasic al protecției endpoint-urilor, adaptată însă unui nou tip de entitate activă. Procesul monitorizat nu este un malware, ci un instrument AI legitim, care poate fi transformat oricând într-o amenințare la adresa utilizatorului prin intermediul conținutului pe care îl accesează. Monitorizarea comportamentală pornește de la premisa că acest lucru se poate întâmpla și se asigură că acțiunile malițioase sunt oprite înainte de a produce efecte.
Concluzie: Verificarea lanțului de aprovizionare
Prin adoptarea AI, companiile se expun unui peisaj de amenințări tot mai extins. Cele care nu înțeleg acest risc ar putea avea parte de surprize neplăcute atunci când agenții AI încep să se comporte într-un mod asemănător lui „Skynet” și manifestă comportamente neprevăzute, precum exfiltrarea datelor. De aceea, adoptarea AI trebuie privită ca o extindere a lanțului de aprovizionare, nu doar ca o implementare software. Fiecare model, skill AI, conector și pachet nou adaugă o verigă de încredere – și un nou punct prin care o compromitere se poate propaga la scară largă.
Întrebări frecvente (FAQ)
Ce înseamnă securitatea lanțului de aprovizionare AI?
Securitatea lanțului de aprovizionare AI presupune identificarea și protejarea tuturor componentelor externe de care depinde un sistem AI, de la modele și skill-uri AI, până la plug-in-uri, pachete software, conectori și surse de date. La fel ca în cazul software-ului tradițional, riscul constă în faptul că o singură componentă de încredere poate deveni, fără să fie observată, o cale prin care atacatorii pot ajunge la numeroase sisteme.
De ce reprezintă agenții AI un risc de securitate?
Agenții AI prezintă riscuri deoarece nu se limitează la generarea de text: pot naviga pe internet, pot accesa și prelua date, pot apela și utiliza instrumente și pot executa acțiuni în numele utilizatorilor. Astfel, o instrucțiune greșită, un skill AI malițios sau o sursă externă compromisă poate transforma un asistent util într-un participant activ la un atac.
Ce este atacul de tip prompt injection în securitatea AI?
Prompt injection este un tip de atac în care instrucțiuni malițioase sunt ascunse în conținutul text pe care îl procesează sistemul AI, cum ar fi o pagină web, un document, un email sau rezultatul generat de un instrument. Riscul crește atunci când sistemul AI este un agent care are permisiunea de a accesa fișiere, de a executa comenzi sau de a transfera date.
Modelele AI open-weight sunt același lucru cu modelele open-source?
Nu întotdeauna. Modelele open-weight permit descărcarea, examinarea și rularea parametrilor rezultați în urma antrenării, ceea ce le apropie, ca principiu, de software-ul open-source. Totuși, accesul la datele de antrenare, codul sursă, metodele de siguranță sau condițiile de licențiere poate fi în continuare restricționat.
Cum pot companiile să reducă riscurile de securitate asociate agenților AI?
Companiile pot reduce aceste riscuri prin stabilirea unor reguli clare privind instrumentele AI permise, verificarea dependențelor utilizate de agenți, limitarea permisiunilor și monitorizarea comportamentului lor la nivelul endpoint-urilor. Scopul nu este de a opri utilizarea AI, ci de a se asigura că automatizările de încredere nu se transformă pe nesimțite într-o amenințare la adresa securității.
Lasa un comentariu